Publié le 22 novembre 2026, un test d’Ouest-France compare les réponses de cinq assistants conversationnels à une demande de diagnostic à partir de symptômes légers. L’expérience porte sur un mal de gorge et un léger mal de tête apparus depuis quelques heures. Les éléments disponibles décrivent le protocole, mais ne permettent pas de connaître les réponses obtenues ni de désigner le modèle le plus pertinent.
Cinq modèles soumis au même scénario
Pour cette comparaison, Ouest-France a interrogé les versions gratuites de ChatGPT, Claude, DeepSeek, Google Gemini et Vibe, le modèle de Mistral AI. Le principe : leur présenter une courte description de symptômes et observer les pistes médicales proposées.
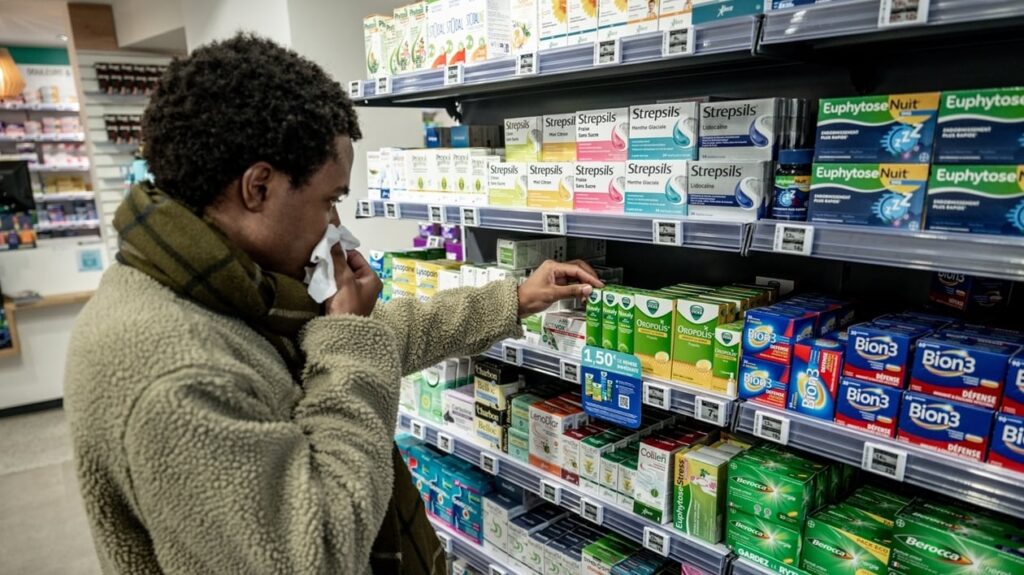
Le scénario commence par un mal de gorge et un peu mal à la tête, ressentis depuis quelques heures. La suite de la consigne n’apparaît pas dans les éléments accessibles. Il est donc impossible de préciser les autres informations communiquées aux modèles ou de comparer le détail de leurs réponses.
Les résultats ne sont pas détaillés dans l’extrait disponible
L’expérience vise à examiner les services que ces outils peuvent rendre face à de petits problèmes de santé et à comparer leur efficacité. Mais les résultats du test, les éventuelles différences entre les réponses et les conclusions de la rédaction ne figurent pas dans le contenu consultable ici. Aucun classement ne peut donc être établi à partir des informations disponibles.
Ce test décrit une mise à l’épreuve de modèles conversationnels à partir d’un cas ponctuel. Les éléments fournis ne permettent pas d’en tirer une conclusion générale sur leur capacité à établir un diagnostic médical.
Source : Ouest France.fr – L'actualité en direct, en continu et en images (www.ouest-france.fr)
Article original : Consulter la source originale